DeepSeek开源DeepInfer推理框架:算子竞争进入AI时代
DeepSeek全面开源推理框架DeepInfer,将模型运行链路彻底开放,FlashMLA等算子已达硬件极限的90%以上。而同一周,全AI编写、无人工调优的ForgeKernel登顶英伟达与昇腾两大算子评测榜,基准加速比1.835×,领先第二名25%,算子优化正式进入AI自主迭代时代。
国产大模型的竞争,正在从模型层悄然延伸到算力层。再强大的模型,最终都要通过一个个算子在芯片上执行;同一个模型、同一块芯片,换一套更优的算子,有时会带来数倍的性能提升。算子的效率决定了同样的显卡能跑多快,也直接决定了每个 token 的价格——这正是 DeepSeek 近日全面开源推理框架 DeepInfer 背后的产业逻辑。
DeepInfer 开源:把模型运行的链路彻底打开
继此前开源模型权重,以及 FlashMLA、DeepGEMM 等算子库之后,DeepSeek 这次把模型运行的完整链路也开放了出来。对开发者而言,这意味着从权重到算子再到推理框架的整条技术栈,都可以自由获取、研究和改进,开源版图进一步补齐。
其中最受关注的是 FlashMLA。有工程师在芯片上逐行手调的版本,算子性能跑到了硬件极限的 90% 以上——这被普遍视为人类手艺目前在部分芯片上所能达到的极限成绩。换句话说,在特定硬件上,人类工程师几乎已经把这个算子榨到了 theoretical 上限附近。
同一周,AI 刷新了人类手写的极限
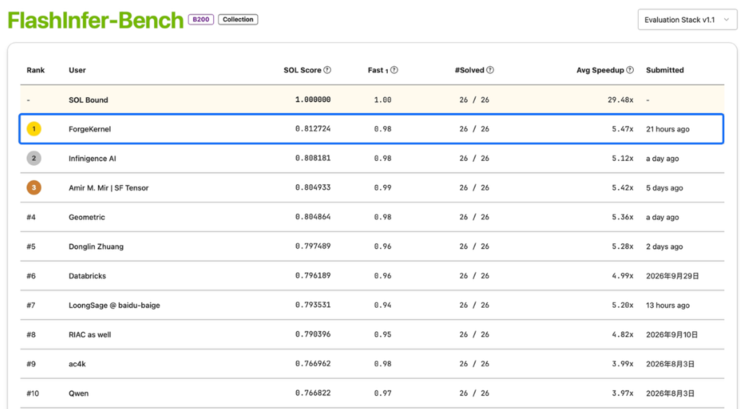
然而这个人类极限,在同一周就被 AI 刷新了。据悉,截至 10 月 22 日,完全由 AI 编写算子、无人工逐行调优的 ForgeKernel,同时登顶两个算子评测榜:一是英伟达主场的 SOL-ExecBench FlashInfer-Bench 合集第一,二是昇腾 CANN 官方仓库维护的 CANNBench A3 硬件榜第一,基准加速比达到 1.835×,领先第二名 25%。
名次之外更值得关注的是其自主优化能力:在 DeepSeek v4.1 Flash 的算子上,相比 DeepSeek 官方开源的英伟达版本,ForgeKernel 通过从零开始用 AI 迭代的方式,同样实现了性能超越。这意味着即便面对全球顶尖团队的工程产出,AI 自主优化也已具备正面竞争力。
算子:决定 token 价格的隐形战场
为什么算子如此重要?因为它是模型与芯片之间的桥梁。算子效率不仅决定同样显卡的吞吐速度,也决定推理成本,进而影响每一家 AI 公司的定价空间和盈利能力。在算力供给受限的环境下,软件层面的优化几乎是性价比最高的降本路径。
同时登顶英伟达与昇腾两个生态的评测榜,还有另一层意义:AI 编写的算子展现了跨硬件平台的适应性。在一个国产芯片快速追赶、多元算力并存的格局中,能够自动适配不同硬件的算子生成能力,价值会愈发凸显。
开源精神与榜单焦灼,指向同一个方向
DeepSeek 的开源传统与 ForgeKernel 的崛起,构成了智能进化的一次接力。前者把最优质的算子和推理链路交给了整个行业,后者则展示了用 AI 加速 AI 的全新范式。无论路径如何,两者最终都导向同一个方向:让国产智能在算力受限的条件下跑得更快、更便宜。
可以预见,算子层的竞争将更加焦灼:人类工程师的手艺极限已被 AI 触碰和超越,未来的优化主力可能会逐步转向 AI 自主迭代,而工程师的角色则转向定义目标、搭建评测与约束框架。对整个行业而言,这既是效率红利,也是新一轮能力洗牌的开始。