英伟达Vera Rubin基础设施登陆谷歌云 A5X实例正式可用
英伟达与谷歌云宣布Vera Rubin基础设施正式可用,A5X实例整合NVL72机架、ConnectX-9超级网卡与谷歌第四代液冷技术,谷歌云计划扩展至96万颗Rubin GPU,首批客户Ineffable Intelligence与WPP已率先落地强化学习与创意智能体应用。
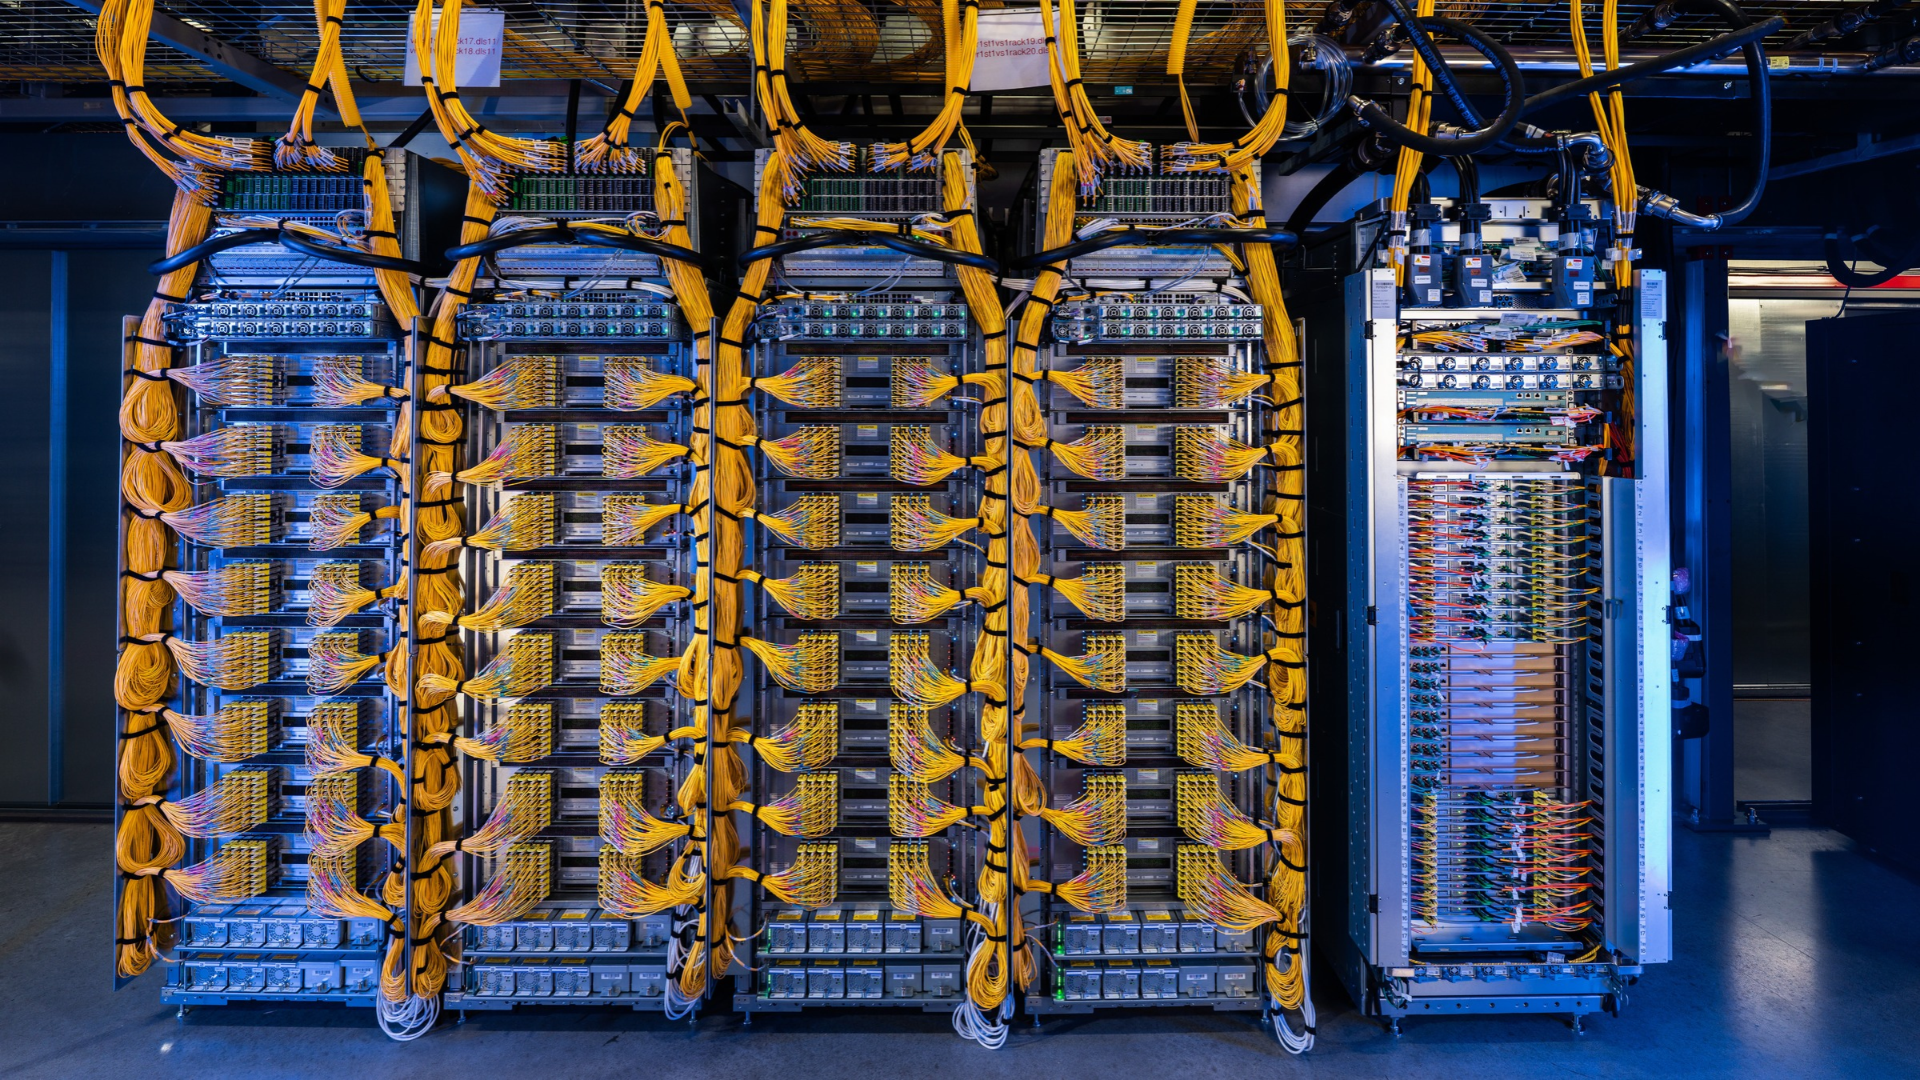
英伟达与谷歌云联合宣布,基于NVIDIA Vera Rubin的A5X实例在谷歌云正式可用,商用实例将于下个月正式推出,并计划将可用范围扩展至欧洲地区。这一整合平台面向云客户,统一支持模型训练、推理以及大规模强化学习工作负载,标志着Vera Rubin架构在公有云上的首个完整落地。
A5X实例:从计算到液冷的全栈整合
A5X实例将NVIDIA Vera Rubin NVL72机架系统、NVIDIA ConnectX-9超级网卡、谷歌云Virgo网络以及谷歌云第四代先进液冷技术整合为一体化平台。这一组合专为高要求的智能体推理与大规模强化学习工作负载设计,能够在机架内部实现极高的计算密度与带宽互联。
根据公告,谷歌云计划将其Vera Rubin基础设施扩展至多达96万颗Rubin GPU,分布在多个数据中心园区。这一规模在业界极为罕见,反映出谷歌云对下一代AI算力需求的强劲预判,也显示出英伟达最新一代平台在超大集群部署中的成熟度。
首批客户:从AlphaGo到“超级学习者”
总部位于伦敦的科技公司Ineffable Intelligence是首家获得A5X访问权的客户。该公司由AlphaGo的创造者David Silver创立,正利用这一平台推进大规模强化学习研究,打造能够从经验中持续学习的“超级学习者”(superlearner)系统。
通过交互进行学习需要不断循环地生成经验、评估结果并更新模型,因此基础设施必须能够大规模地支撑这一完整流程。A5X将Vera Rubin作为集成系统纳入谷歌云AI Hypercomputer,将计算、网络与存储结合在一起,以支撑经验驱动的规模化学习。
“我们正在构建能够通过自身经验不断改进的超级学习者。这既需要大量算力,也需要经验生成与训练之间的紧密连接,使智能体的每一次改进都能迅速塑造下一次经验。Vera Rubin在Vera CPU与Rubin GPU之间、以及机架内Rubin GPU之间的高带宽互联,让我们能够把强化学习研究的规模和雄心推向更远。”David Silver如是说。
WPP:创意智能体在单实例上跑通多节点任务
同样位于伦敦的营销传播巨头WPP也基于A5X实例演示了其创意智能体参考架构,采用了NVIDIA Nemotron模型以及NVIDIA OpenShell。OpenShell是NVIDIA面向安全AI智能体的OpenShell参考架构的组成部分。
这些智能体能够将对话式请求转化为多步骤创意工作流,例如视频生成、画质增强与风格重塑,并在执行前由人工审批。OpenShell为智能体执行提供受治理的沙箱环境,帮助企业控制对敏感品牌资产和创意工具的访问。值得注意的是,在WPP的初步测试中,过去通常需要多节点集群才能运行的工作负载,如今在单个A5X实例上即可完成。
机密计算与能效布局
随着智能体系统的大规模部署,企业需要在非自有基础设施上保护驱动这些系统的专有模型与敏感数据。谷歌云将成为首批在裸金属实例上提供机架级NVIDIA机密计算的云服务商之一,该能力将率先应用于由GB300 NVL72驱动的A4X Max实例。
此外,谷歌云正在由RTX PRO 6000 Blackwell服务器版GPU驱动的G4虚拟机上正式提供机密计算能力,为机密推理与微调提供灵活平台。目前已有Vertebrae、Polaris Cloud和Confidential Core AI等客户在使用Confidential G4,应用于对话隐私保护、可验证的智能体执行以及受策略约束的企业智能等场景。
在能效方面,谷歌云与英伟达正在为Vera Rubin基础设施探索NVIDIA DSX MaxLPS能力,以优化每瓦性能,帮助企业在现有数据中心电力预算内扩展容量。这对于面临供电约束的超大规模数据中心而言尤为关键。
展望未来,随着A5X实例下月正式商用并向欧洲扩展,Vera Rubin平台将在训练、推理与强化学习三大场景形成完整云上能力,96万颗GPU的规划规模也将为下一代智能体AI提供坚实的算力底座,进一步强化谷歌云与英伟达在全球AI基础设施竞争中的联合优势。