OpenAI披露前沿模型训练环境的安全隔离体系
OpenAI首次系统披露其前沿模型训练与评估环境的安全防护机制,包括离线隔离环境、高强度算力红队测试与信息封锁流程,旨在防范模型权重泄露、供应链攻击与内部威胁,为行业前沿AI安全实践提供参考样本。
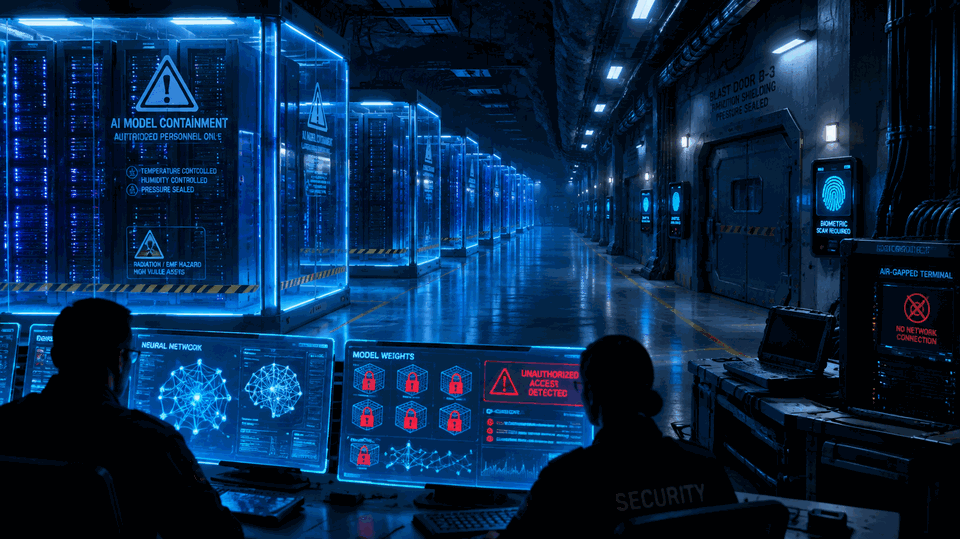
OpenAI近日发布题为《 securing our frontier model training environment(保护我们的前沿模型训练环境)》的文章,首次较为系统地介绍了公司如何为前沿模型的训练与评估过程构建安全隔离体系。文章指出,随着模型能力不断增强,训练环境本身已经成为攻击者眼中的高价值目标,OpenAI为此在物理隔离、网络隔离、信息隔离和高算力红队测试等多个层面进行了持续加固。
为什么训练环境需要被当作核心资产保护
OpenAI在文中说明,前沿模型的训练过程集中了公司最有价值的资产之一:尚未发布的模型权重、训练数据管线以及相关的基础设施配置。一旦这些信息在训练阶段泄露,攻击者不仅可能窃取知识产权,还可能在模型发布前就了解其能力边界,从而规避安全部署措施。
为此,OpenAI将“信息隔离”作为设计原则贯穿训练全流程:参与训练的团队只能接触到与其职责直接相关的系统和数据,跨团队的信息流动受到严格限制。这种做法借鉴了成熟的安全行业经验,即通过缩小单个内部人员或单台设备被攻破后的影响范围,来降低整体风险。
离线环境与物理隔离:切断攻击路径
文章披露的重点之一是离线(offline)训练与评估环境。OpenAI介绍,部分最敏感的训练与评估工作被安排在与互联网物理或逻辑隔离的环境中执行,相关系统不与外部网络直连,代码、数据和模型权重的进出都经过受控的审查流程。
这种“气隙式”的隔离手段,显著增加了外部攻击者通过互联网渗透进入训练基础设施的难度,也限制了内部数据被意外或恶意外传的通道。OpenAI强调,隔离并不意味着效率的彻底牺牲,公司围绕离线环境建立了配套的工作流程,使研究人员仍能在受控条件下高效开展实验。
高算力红队测试:主动发现薄弱环节
除被动防御外,OpenAI还投入大量算力开展“高算力红队测试”(high-compute red-teaming)。其思路是:红队团队利用大规模计算资源,模拟真实攻击者的各种手段,包括针对软件供应链、内部权限体系以及评估流程本身的攻击尝试,以主动发现和修补薄弱环节。
OpenAI认为,传统的渗透测试难以覆盖前沿模型训练这种超大规模分布式系统的复杂性,而拥有与实际训练相匹配的算力,才能让红队在接近真实的条件下检验防护体系的有效性。这种把安全验证常态化、算力化的做法,被认为是前沿实验室安全投入的一次升级。
行业背景:前沿AI安全竞争正在加速
OpenAI此次披露正值全球对前沿AI安全关注度持续升温之际。过去一年间,多家头部实验室相继发布“负责任扩展政策”(Responsible Scaling Policies),承诺在模型能力跨越特定阈值时启用更严格的安全标准,包括对训练环境和模型权重的保护要求。同时,美国与欧盟的监管框架也在推动对高能力模型开发过程的安全审查。
从这一背景看,OpenAI的文章不仅是技术措施说明,也带有一定的行业示范与沟通意味:向公众、合作方和监管者展示公司在模型发布之前做了哪些安全准备。业内观察人士普遍认为,训练环境隔离、权重保护与红队测试,未来有望成为前沿实验室的“标配动作”,而细节透明度将成为外界评估各家公司安全水平的重要依据。
后续影响与展望
对行业而言,OpenAI的披露可能产生两方面影响。其一,其他前沿实验室面临跟进压力,需要在离线基础设施、权限管理和安全团队规模上加大投入;其二,安全工程的细节披露有助于形成行业共识与最佳实践,推动第三方审计和标准化评估的发展。
展望未来,随着下一代模型在能力上继续逼近甚至超越当前水平,训练环境的安全保障将从“加分项”变为“准入门槛”。OpenAI表示将持续更新并完善这套隔离与红队机制,并在能力显著提升时同步强化对应的安全措施。对于整个AI生态来说,如何在开放透明与严密防护之间取得平衡,仍将是长期课题。