微软AI诊断力压医生登Science,超智能医疗叙事引发质疑
微软CEO穆斯塔法·苏莱曼宣称其AI诊断系统在疑难病例上超越全科医生,研究成果登上《科学》杂志,并抛出医学超级智能愿景。但分析指出,性能提升主要来自底层模型本身,微软系统的独立贡献存疑,业界对此争议不断。
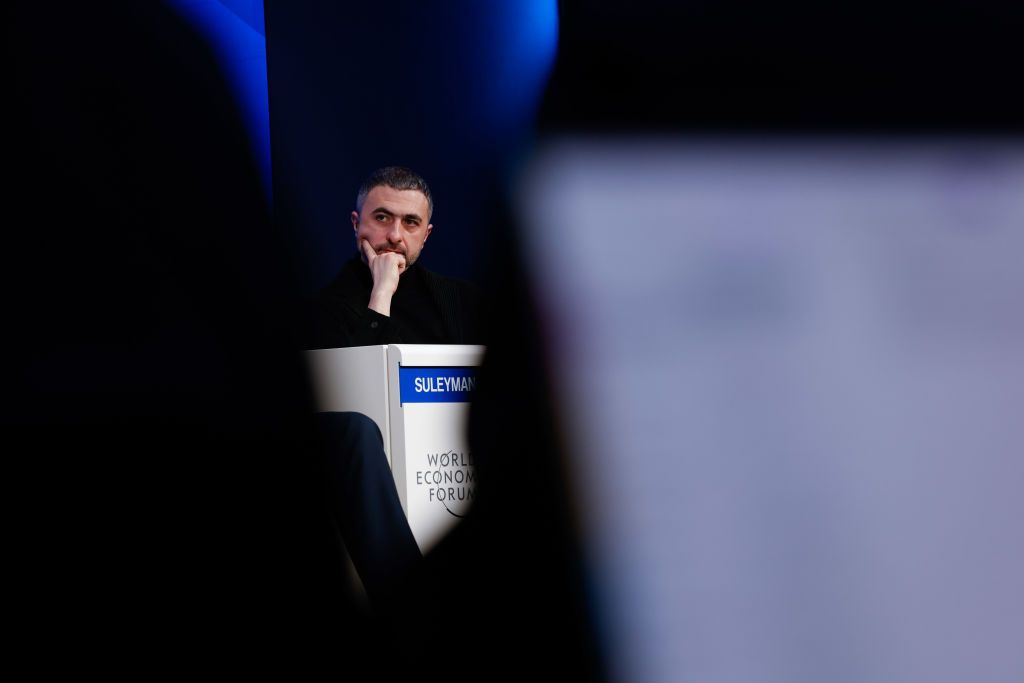
2026年10月22日,据TechCrunch报道,微软AI部门负责人穆斯塔法·苏莱曼(Mustafa Suleyman)高调宣布,微软新推出的AI诊断系统在疑难病例的诊断表现上超越了全科医生,相关研究成果已刊登于顶级学术期刊《科学》(Science)。苏莱曼同时描绘了迈向医学超级智能(medical superintelligence)的宏大路线图。然而,这篇论文的另一项发现却给这则消息泼了冷水:大部分性能提升似乎来自系统底层的AI模型本身,而非微软自研的系统框架。
疑难病例上的表现超越医生
根据发表于《科学》杂志的研究,微软搭建的AI诊断系统在一组精心挑选的疑难病例上进行了测试,对照组是执业的全科医生。结果显示,该AI系统在处理这些高难度病例时的整体表现优于人类医生,这一结论成为苏莱曼对外宣传的核心卖点。要知道,疑难病例诊断历来被认为是临床医学中最考验经验与推理能力的环节,AI若能在此类场景中稳定胜出,其意义远超一般的辅助诊断工具。
苏莱曼借此抛出了医学超级智能的概念,认为AI不仅在特定任务上可以与医生比肩,而且有望在系统性整合医学知识、推理病例方面达到超越人类专家的水平。这一表态延续了其一贯的激进风格——作为DeepMind联合创始人、Inflection AI创始人和如今的微软AI掌门人,苏莱曼历来以对AI前景的乐观判断著称。
成绩归因:模型的功劳还是系统的功劳?
然而,这篇报道同时指出了关键争议点:研究显示,大部分的性能提升似乎来自系统底层所使用的AI模型,而不是微软围绕这些模型构建的诊断系统本身。换言之,即便不套上微软的诊断框架,底座模型的原始能力或许已经能取得相近的成绩。这意味着微软系统在架构设计、流程编排上的独立贡献可能被高估了。
这一细节对公众理解技术进展至关重要。当一家公司宣称自家系统超越人类专家时,外界自然会追问:超越医生的是微软的工程能力,还是其采购或接入的基础模型?如果答案偏向后者,那么医学超级智能的叙事更多是对行业整体模型进步的一种包装,而非微软独有的突破。
苏莱曼表示,其AI在疑难病例上的表现优于全科医生,微软正朝着医学超级智能的目标迈进。
登上《科学》意味着什么
尽管存在归因争议,研究成果能够登上《科学》杂志本身仍具分量。《科学》作为全球最具影响力的学术期刊之一,对研究设计的严谨性、数据质量和结论的可复核性有较高要求。AI诊断研究此前多见于预印本平台或行业白皮书,由医生参与的前瞻性对照研究能够进入顶级期刊,说明这类人机对比实验的方法学正在走向成熟。
但学术界也提醒,登上顶刊不等于可以直接用于临床。从回顾性病例评估到真实诊疗环境中的安全应用,中间还隔着监管审批、责任界定、误诊纠错机制等多重门槛。AI在测试集上的胜出,与它能在门诊中安全接管诊断决策,完全是两回事。
医学超级智能:愿景还是营销?
苏莱曼的医学超级智能论在业界引发了明显分歧。支持者认为,AI在诊断这类可量化任务上超越人类只是时间问题,微软的入局和顶刊背书加速了这一进程;质疑者则指出,将一次基准测试的胜利升格为超级智能叙事,有过度营销之嫌,尤其当论文自身都承认性能主要来自底层模型时,宣传口径与证据之间出现了明显落差。
还有观点认为,医疗AI的真正瓶颈不在诊断准确率,而在临床工作流整合、医患信任与法律框架。即便AI诊断能力持续提升,医生的角色也不会简单被替代,而是转向监督、沟通与复杂决策仲裁。把叙事焦点放在人机对决上,可能误导公众对医疗AI发展阶段的认知。
后续影响与行业走向
对微软而言,这项研究是其在医疗AI赛道的重要落子。在OpenAI、谷歌等对手纷纷布局医疗健康的背景下,微软需要拿出标志性成果证明其AI部门在苏莱曼领导下的独立产出能力。而围绕归因的争议,也可能促使公司在后续版本中更清晰地展示系统层面对性能的实际贡献。
对整个行业来说,这则新闻再次凸显了AI医疗传播中的核心张力:技术进步是真实的,但叙事包装常常跑在证据前面。随着更多同行评审研究出现,医学超级智能究竟是五年内的现实,还是长期的营销话术,市场很快会给出答案。
展望未来,AI诊断系统的进化方向将不再只是刷高基准成绩,而是证明自己在真实临床环境中的可靠性、可解释性与经济价值。微软此次登上《科学》是一个信号,但医学超级智能的成色,还需要经受监管、医生和患者的多重检验。