微软发布Quine:面向生物学的多模态世界模型
微软研究院发布实验性AI系统Quine,包含生物学世界模型与交互框架两大组件,在与哈佛和麻省理工布罗德研究所的合作中,用一个周末完成数千种化合物筛选并获湿实验验证;首批Quine Fellows现已开放申请。
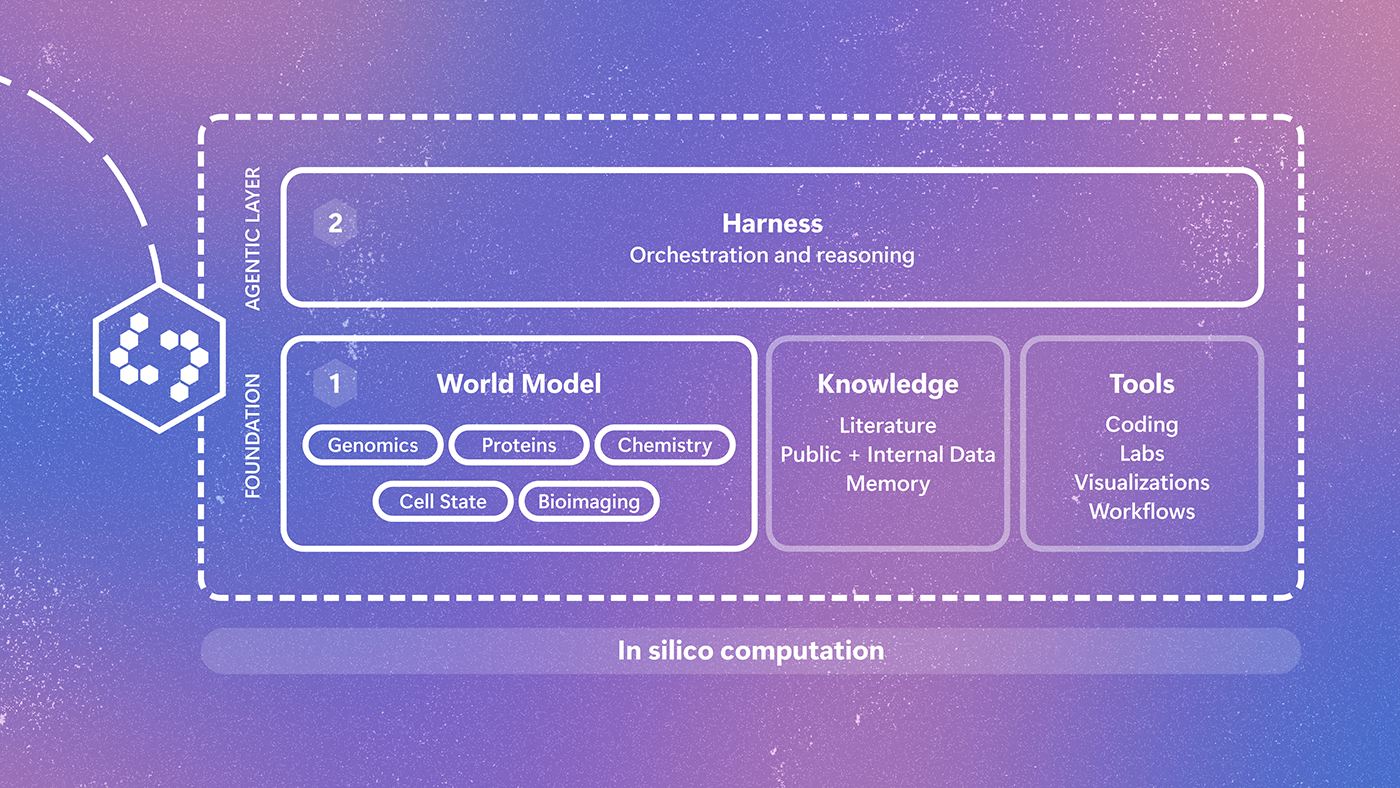
微软研究院正式发布一项名为 Quine 的研究计划,目标是打造一个覆盖生物学的多模态世界模型,并配套一个把模型、科研工具、科学文献与研究人员连接起来的交互框架。根据微软研究博客的介绍,在与麻省理工学院和哈佛大学布罗德研究所的合作中,该系统已筛选出一批有望驱动治疗性肿瘤状态转变的化合物,其中多个排名靠前的候选者在多项湿实验室检测中获得验证。目前 Quine 仍是仅供科研的实验性技术,不得用于临床或医疗用途,首批 Quine Fellows 计划的申请通道现已开放。
二十年积累:生物学不会按模型的边界切分自己
在计算与生物学的交叉地带,微软研究院已经深耕二十余年,研究足迹横跨免疫学、病毒学、基因组学、生物医学成像、细胞生物学和蛋白质工程,并产出过走向临床的成果——从罕见病与传染病的诊断技术,到癌症生物标志物检测。
但团队在博客中强调,这些年的工作凝练出一个越来越清晰的教训:生物学并不会按照模型和工具所习惯的整齐边界来切分自己——基因影响蛋白质,蛋白质在细胞内相互作用,细胞组织成组织,而实验又不断重塑科学家知道什么、下一步该问什么。因此,攻克最难的生物学问题,需要的不再只是针对单一数据集或单一任务越来越强的模型,而是能够跨尺度、跨模态连接知识、围绕实验与证据展开推理、并参与到科学迭代过程之中的系统。
另一方面,实验技术的改进和湿实验室通量的提升,并没有消除生物学的根本约束:自然无法被催促,也无法从第一性原理推导,实验节奏缓慢、迭代周期漫长,许多关键问题涉及相互作用、组合式设计空间和庞大到无法逐一实验探索的下游效应。与此同时,通用基础模型和能够迭代解题的推理模型相继崛起,人类语言领域发展出的许多技术被证明可以迁移到生物系统的表征学习上。这促使团队提出了一个大胆的问题:建造一个生物学的世界模型,究竟需要什么?
双组件架构:世界模型加交互框架
按照微软研究院的定义,世界模型是一个能够表示生物系统状态、预测该状态在干预之下如何演化、并对干预后果进行多步推理的系统。它并不取代实验,而是在投入稀缺的实验室资源之前,用计算去探索、提出、排序和筛选可能的前进路径。团队的北极星,是科学家、模型与实验在一个持续加速的循环中协同运转的未来。
“世界模型并不需要完美——它永远无法完美地模拟生物学——它只需要切实有效地指导实验设计。”——微软研究博客
Quine 是迈向这一愿景的第一步,由两大前沿组件构成:一是生物学世界模型,二是交互框架,后者把模型与负责编排和推理的模型、科研工具、文献以及使用它们的科学家团队连接起来。整个循环始于科学家、也终于科学家:一个问题变成一组候选方案,方案变成值得测试的实验设计,实验返回的测量结果再同时打磨科学家的下一个问题和模型本身。
世界模型的核心是跨模态、跨尺度地学习共享表征,覆盖序列、结构、功能、细胞状态与成像数据;训练模态包括基因组学、蛋白质、化学、RNA 与细胞状态、生物成像。由于这些表征是联合训练所得,而非由系统编排多个单领域专家模型,一个层面的证据可以为另一个层面的预测提供支撑。团队特别指出,这种多模态设计不仅没有稀释性能,反而增强了模型的泛化能力,使其能够支持更广泛的生物学推理任务。
胰腺癌实战:数千种化合物,一个周末的筛选
Quine 的首个实战场景来自胰腺导管腺癌(PDAC)——最常见的胰腺癌类型,也是最难治疗的癌症之一。多年来,微软与布罗德研究所合作开发并应用患者来源的离体模型,验证一个长期假设:肿瘤行为与药物反应不仅取决于遗传因素,还取决于转录层面的细胞状态;在 PDAC 中,肿瘤细胞可以处于与治疗反应相关的不同细胞状态。
借助 Quine,团队把这一假设真正付诸实践,探索癌症的非遗传特征——尤其是细胞状态——能否成为可操作的干预靶点。系统依据化合物推动肿瘤细胞在治疗相关状态之间转变的潜力,预测并排序了数千种化合物;在聚焦经典型向基底型状态转变的湿实验中,Quine 排名最高的化合物确实产生了最大的预期转变。从快速压缩化合物搜索空间,到筛出少数值得进入实验室验证的候选者,整个过程只用了一个周末,有望节省数月的实验工作和可观的科研成本。
值得注意的是,一些最强效果来自作用机制出乎意料的化合物,这为 AI 挖掘药物再利用与全新发现提供了早期证据。反向转变(从基底型回到经典型)被证明更难,而 Quine 恰好预测了现有化合物的这种较弱效果;更出乎意料的是,模型预测若干化合物会持续把细胞推向第三个表型,实验结果也印证了这一点,说明胰腺癌的细胞状态版图比简单的经典—基底双轴更为丰富——实验不仅检验了模型的假设,还生成了新的假设。团队接下来将引入新整合的 RNA 数据集与任务,强化状态转变预测,并提供经过校准的置信度估计,帮助科学家优先安排最有价值的湿实验。
开放与克制:Fellows 计划与分阶段访问
Quine 源自微软自身的科研流程:随着系统演进,团队把它嵌入癌症生物学、蛋白质工程、基因组学和生物成像等多个正在进行的科学项目,每一个研究问题、实验结果与意外发现都成为改进模型与工作流的机会。但团队明确表示,不希望它的后续开发在封闭中进行,许多决定其走向的问题需要更广泛科学共同体的专业判断与创造力。
- 首批 Quine Fellows 计划现已开放申请:入选科学家将直接使用该系统,加速自身研究并向微软提供科学反馈。
- Quine 仅为实验性研究技术,不得用于临床或医疗;其输出可能不完整或不准确,须由合格研究者审查并经过适当的科学与实验验证。
- 微软采取分阶段开放策略:初期仅面向 Fellows 计划与选定的研究合作,辅以持续的内部审查与内置安全防护;技术成熟后,计划通过 Microsoft Discovery 等产品扩大访问范围。
团队还提醒,用基准测试和排行榜来衡量 AI for Biology 的进步固然诱人,但 Quine 真正的考验在于面对科学实际运作方式时的表现:当证据不完整时它是否依然有用?面对从未被问过的问题它能帮上什么?它能否把从问题到发现的路径变得更短?
从长远看,Quine 的雄心是让 AI 退入科学实践的背景之中,而让科学家始终站在发现循环的中心。如果预测、实验、反馈、再训练的闭环能够持续转动,生物学研究的经济学将被改写:昂贵的湿实验资源将集中投向模型筛选出的最高价值假设,而每一次实验结果又会成为下一代系统的训练信号。对 AI for Science 赛道而言,微软此次交出的不只是一个新系统,更是一种可复制的范式样本——其成色如何,第一批 Quine Fellows 的科研实践将最先给出答案。